基础极速入门
输入端token 常见分词逻辑是通过字词分词。 如果通过字符分词,比如一个字母,那么它的序列长度会很长,一个单词就会产生很长的序列。注意力成本它是O(n^2)级别的,所以说难以学习长程的语义; 而通过…
总览:
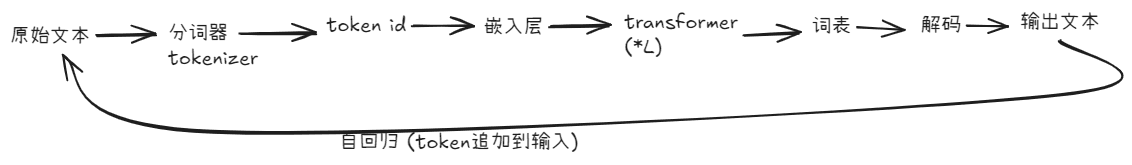
输入端token
常见分词逻辑是通过字词分词。 如果通过字符分词,比如一个字母,那么它的序列长度会很长,一个单词就会产生很长的序列。注意力成本它是级别的,所以说难以学习长程的语义; 而通过词分词,比如通过一个词语或者单词,虽然它的序列长度会变得很短,但是词表长度会变得非常长,譬如有几十万格。而且在遇到陌生的单词时(如拼错的内容),会无法处理。 所以我们一般采用中间态,对常用词分为一个Token。对于非常见词,通过递归构造多token。
字节对编码BPE:最主流的编码
其他概念
分词膨胀率:衡量不同语言在分词器中平均每个单词被切成的Token长度;膨胀率高,即说明一个单词被分成的Token长度越多,说明该分词器对该语言的覆盖能力较差。(分词器)(一般在任务中,我们考虑任务成本)
特殊token:表达特殊任务结构,它在训练的时候就被标记为了硬边界的处理;如果模型天然支持这种结构,尽量优先使用模型的。(有的时候,尽管你以为的提示词设计的比较好,但是我们自己造出来的提示词。它的处理方式和处理自然语言文本是一样的,依旧是概率支持,可能会出错,在单轮中可能看不出正常与否,长上下文中可能会产生偏离;而如果我们使用模型自身支持的任务切分结构)(类似于json输出工具调用,为什么要用原生的而不是直接输出)
ps:之前mt说很多智能体框架是基于Langchain改的,如果这么说,好像似乎有些说得通,但是不知道是不是
EOS处理:模型不会自己停下,除非输出碰到了EOS特殊Token
(如果不加以处理,会一直输出,直到到Max Tokens)
Q: 为什么模型无法计算得到正确的结果? A: 模型会把数字比如2026切分成四个数字,并且把它转换为Token ID。那么模型都没有见过这个真正的数字,只有这个Token ID,无法还原出原来结构,自然无法算出正确的结果。所以一般来说会把运算交给工具处理.
transformer
有1M上下文,并1M不代表上下文完全可用,所以我们一般要把任务控制在甜点token区间内
文本生成:解码策略
对于PyTorch的一些坑点,目前记录在PyTorch基础
反向链接(0)
还没有笔记链接到这里。在 Obsidian 里用 [[笔记名]] 引用它,这里就会出现,关系图谱上也会多出一条连线。