LLM
智能体构建tricks
1. 善于使用Reflection自我反馈反思优化:在LLM生成出答案后,可以让LLM重新自检一遍。可能有助于提升准确率。 2. 模型评估打分:我以前做过这方面了解,而且发现并调研出模型对于评价了两个…
最后更新 2026年8月23日
- 善于使用Reflection自我反馈反思优化:在LLM生成出答案后,可以让LLM重新自检一遍。可能有助于提升准确率。
- 模型评估打分:我以前做过这方面了解,而且发现并调研出模型对于评价了两个回答的好坏,它有位置偏好(即模型对于两个需要比较评价的东西,它往往会选择第一个选项,而不是看实际的情况),所以它评价并不是那么准确。所以可以尝试多维度打分,当然,与其从0
5打分,不如让它回答一个二元的问题。然后人工进行分数的计算,因为05的打分也是主观性更大一些,比如你可以给10个二元性的评估标准。然后人工手动加分来获得两个图片的好坏。这样会更客观一些。
Tip
所以有了评估打分,可以尝试使用积累评估准则,比较带有Reflection前后两个模型回答生成后的效果。也可以优化Reflection的提示词。
这是对于主观性的问题上的一个尝试解决方法。那么对于客观性的问题,自然更好进行评测,在此不再赘述。 3. 可以考虑引入外部的反馈机制,提升在提示词优化后LLM模型的表现上限。
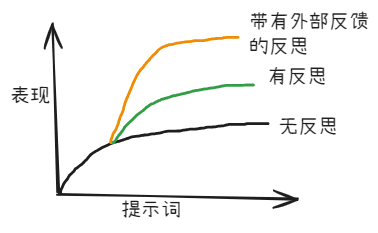 我们画张图表示一下,一个常见的事例就是在做Coding Agent的时候,编译器返回报错结果。
再举一个简单的例子,比如我们在用LLM生成一个播客,通常LLM在掌控文章字数不是很好,那么我们完全可以在大模型生成文章以后。然后通过文字长度检测工具来判断是否超出,然后反馈重新生成。
反向链接(0)
还没有笔记链接到这里。在 Obsidian 里用 [[笔记名]] 引用它,这里就会出现,关系图谱上也会多出一条连线。